


Ce que fait la superposition Identity
Identity est une superposition vectorielle. Vous lui donnez deux couches. La couche d’entrée contient les entités que vous voulez garder, par exemple des parcelles, des routes ou des puits. La couche Identity contient des polygones avec des attributs, par exemple des zones inondables, des zonages d’urbanisme ou des types de sol. L’outil fait deux choses à la fois. Là où une entité d’entrée recoupe un polygone Identity, il découpe ce morceau et y copie les attributs du polygone. Là où l’entité d’entrée ne recoupe rien, il garde ce morceau et laisse vides les champs Identity.
Le résultat couvre toujours toute la couche d’entrée. Aucune surface, aucune longueur de ligne et aucun point n’est perdu. C’est la grande différence avec Intersect (qui écarte tout ce qui est hors du chevauchement) et avec Union (qui ajoute aussi les polygones Identity qui ne touchent aucune entrée). Chaque morceau de sortie porte tous les attributs de son entité d’entrée. Les morceaux situés dans un polygone Identity portent en plus les attributs de ce polygone. En formule : Identity(A, B) = Intersect(A, B) + Erase(A, B). C’est la même règle que l’outil Identity d’ArcGIS Pro et de l’ancien ARC/INFO.
J’ai créé cet outil parce que « découpe mes parcelles par zone et garde les deux tables attributaires » est une tâche de tous les jours, et que la réponse habituelle est un SIG bureautique avec la bonne licence. Déposez sur la carte un Shapefile zippé, un GeoJSON, un KML, un KMZ, un GPX ou un WKT, ou dessinez vos propres formes. Choisissez la couche d’entrée et la couche Identity, cliquez sur Lancer Identity et téléchargez le résultat. Tout le calcul géométrique se fait dans votre navigateur, vos fichiers restent donc sur votre ordinateur. La carte démarre sans fond de carte pour rester rapide, et vous pouvez activer un fond routier ou satellite à tout moment.
Identity, Union, Intersect, Erase et Spatial Join : lequel vous faut-il ?
Les outils de superposition se confondent facilement, car tous combinent deux couches. La différence tient à la géométrie qu’ils gardent et aux attributs qui finissent dans la sortie. Ce tableau les compare pour une couche d’entrée A et une couche de superposition B.
| Outil | Géométrie gardée | Attributs dans la sortie |
|---|---|---|
| Identity (cet outil) | Tout A, découpé par B | A partout, plus B là où elles se chevauchent, champs de B vides ailleurs |
| Union | Tout A et tout B, découpés là où ils se chevauchent | A et B là où elles se chevauchent, un seul côté ailleurs |
| Intersect | Seulement la partie où A et B se chevauchent | A et B ensemble |
| Erase | Les parties de A hors de B | Seulement A |
| Clip | Les parties de A dans B | Seulement A |
| Différence symétrique | Les parties de A hors de B et les parties de B hors de A | A et B, chacune sur ses propres parties |
| Spatial Join | A inchangée, sans découpe | A plus les attributs de l’entité de B trouvée par sa position |
Une façon rapide de choisir : si vous devez garder toute l’entrée et savoir aussi dans quelle zone, quel secteur ou quelle classe tombe chaque partie, utilisez Identity. Si seul le chevauchement compte, utilisez Intersect. Si vos entités ne doivent pas être découpées, utilisez plutôt une jointure spatiale.
Autres noms de la superposition Identity
La même opération porte des noms différents selon les logiciels, et on les cherche tous. Voici vers quoi pointe chaque nom.
| Nom que vous connaissez | Où vous le voyez | Ce qu’il signifie |
|---|---|---|
| Identity | ArcGIS Pro, ArcMap, arcpy | Le nom d’origine. Boîte Analysis > Overlay > Identity, et arcpy.analysis.Identity. |
| Overlay avec how="identity" | GeoPandas | geopandas.overlay(df1, df2, how="identity") renvoie les mêmes morceaux et les mêmes champs. |
| Intersection + Différence, fusionnées | QGIS | QGIS n’a pas d’outil nommé Identity. Lancez Intersection et Différence, puis fusionnez les deux sorties. |
| Union, puis retrait des parties propres à Identity | QGIS, ArcGIS | Union garde aussi les polygones présents seulement dans B. Retirez-les et vous obtenez un résultat Identity. |
| st_intersection + st_difference | R (paquet sf) | Les deux moitiés d’un Identity, réunies avec rbind. |
| ST_Intersection + ST_Difference | PostGIS | Les deux mêmes moitiés en SQL, réunies avec UNION ALL. |
| Superposition vectorielle, superposition de polygones, analyse par superposition | Manuels de SIG | Le sujet général. Identity est l’une des opérations de superposition standard, avec union, intersect, erase et clip. |
| Transfert d’attributs par superposition, étiquetage par zone | Aménagement et travail environnemental | Des noms simples pour l’usage d’Identity : étiqueter chaque partie d’une entité avec la zone où elle se trouve. |
Si vous cherchiez « comment découper un shapefile avec un autre shapefile en gardant les deux tables attributaires », voici l’outil.
Formats de fichier pris en charge
Vous pouvez charger plusieurs fichiers à la fois et mélanger les formats. Chaque fichier devient sa propre couche dans le panneau Couches. Une couche d’entrée peut contenir ensemble des points, des lignes et des polygones, et chacun est traité avec la bonne méthode.
Formats d’entrée (ce que vous pouvez envoyer)
| Format | Extension | Remarques |
|---|---|---|
| GeoJSON | .geojson, .json | Une FeatureCollection, un Feature seul ou une géométrie seule. Une GeometryCollection est découpée en ses parties. |
| Esri Shapefile | .zip | Zippez ensemble les fichiers .shp, .shx et .dbf. Ajoutez le fichier .prj et les données projetées sont converties en WGS84 au chargement. Un fichier .cpg fixe l’encodage du texte. |
| KML | .kml | Repères Google Earth. MultiGeometry est découpée en ses parties, et ExtendedData devient des attributs. |
| KMZ | .kmz | Un fichier KML zippé. Le premier fichier .kml de l’archive est lu. |
| GPX | .gpx | Fichiers GPS. Les waypoints deviennent des points, et les traces et itinéraires deviennent des lignes. Les altitudes sont conservées. |
| WKT | .wkt, .txt | Well-Known Text. Une géométrie pour tout le fichier, ou une géométrie par ligne. |
Formats de sortie (ce que vous pouvez télécharger)
| Format | Extension | Remarques |
|---|---|---|
| GeoJSON | .geojson | Le format web standard (RFC 7946) en WGS84. Garde chaque attribut et son type. S’ouvre dans ArcGIS Pro, QGIS et presque toute bibliothèque de cartes web. |
| KML | .kml | S’ouvre dans Google Earth. Les attributs sont écrits en ExtendedData sur chaque repère. |
| CSV (WKT) | .csv | Une ligne par entité. La première colonne contient la géométrie en WKT, et chaque attribut a sa propre colonne. S’ouvre dans Excel, et QGIS peut lire la colonne WKT comme géométrie. |
Chaque fichier peut peser jusqu’à 50 Mo. Pour de très gros jeux de données nationaux, un SIG bureautique reste le meilleur choix. Voir la comparaison plus bas dans cette page.
Détails techniques
Voici exactement ce que l’outil fait de vos données. Si vous connaissez Identity dans ArcGIS Pro, presque tout vous sera familier.
- Types de géométrie d’entrée
- Point, MultiPoint, LineString, MultiLineString, Polygon et MultiPolygon. Une couche peut tous les mélanger.
- Types de géométrie de la couche Identity
- Polygon et MultiPolygon, avec ou sans trous. Une couche sans polygones ne peut pas être choisie comme couche Identity.
- Plusieurs polygones Identity
- La couche Identity n’est pas fusionnée. Chaque polygone garde ses propres attributs. Là où deux polygones Identity se chevauchent, l’entrée est découpée une fois pour chacun, le chevauchement apparaît donc deux fois, une fois avec chaque jeu d’attributs. C’est ainsi que fonctionne Identity dans ArcGIS.
- Attributs
- Chaque attribut de l’entité d’entrée est copié sur chaque morceau de sortie. Les attributs du polygone Identity sont ajoutés comme nouveaux champs. Les morceaux qui tombent hors de tous les polygones Identity reçoivent des valeurs vides (null) dans ces champs.
- Conflits de noms de champ
- Si un champ Identity porte le même nom qu’un champ d’entrée, le champ d’entrée garde son nom et le champ Identity reçoit un suffixe :
namedevientname_1, puisname_2, et ainsi de suite. La boîte de résultats liste chaque champ renommé. - Champs de suivi
- En option, l’outil ajoute
FID_input(la position de l’entité d’entrée, à partir de 0),FID_identity(la position du polygone Identity, ou -1 s’il n’y en a pas),identity_status(overlap ou input_only) etidentity_area_m2,identity_length_mouidentity_pointspour chaque morceau. - Système de coordonnées
- Longitude et latitude WGS84 (EPSG:4326), comme GeoJSON. Un Shapefile zippé avec un fichier .prj est converti en WGS84 au chargement.
- Modèle géométrique
- La découpe se fait sur un plan en degrés, le même modèle que Turf.js et la plupart des bibliothèques SIG web. Les surfaces et longueurs du panneau de résultats sont mesurées sur la sphère (géodésiques), en mètres carrés et en mètres.
- Règle du bord
- Le bord d’un polygone Identity compte comme à l’intérieur. Un point exactement sur le bord reçoit les attributs de ce polygone, de même qu’un tronçon de ligne qui longe le bord. Un polygone qui ne touche le bord que de l’extérieur n’est pas découpé.
- Sortie multipartie
- Si une superposition découpe une entité en plusieurs parties avec les mêmes attributs, les parties restent ensemble comme une entité multipartie (MultiLineString, MultiPolygon ou MultiPoint). Cochez « Diviser les résultats multiparties en parties simples » pour obtenir une entité par partie.
- Géométrie invalide
- Si le calcul géométrique échoue pour une entité d’entrée, cette entité est ignorée et comptée, et le reste de la couche est quand même traité.
- Confidentialité
- Tout s’exécute dans votre navigateur. Aucun fichier et aucune géométrie n’est envoyé à un serveur.
Comment utiliser l’outil Identity, pas à pas
Voici tout le déroulement avec les données d’exemple intégrées : une couche de ville avec des parcelles, des routes et des points, et trois polygones de zones inondables qui portent un nom de zone, un niveau de risque et une profondeur d’inondation. Vos propres fichiers fonctionnent de la même façon.
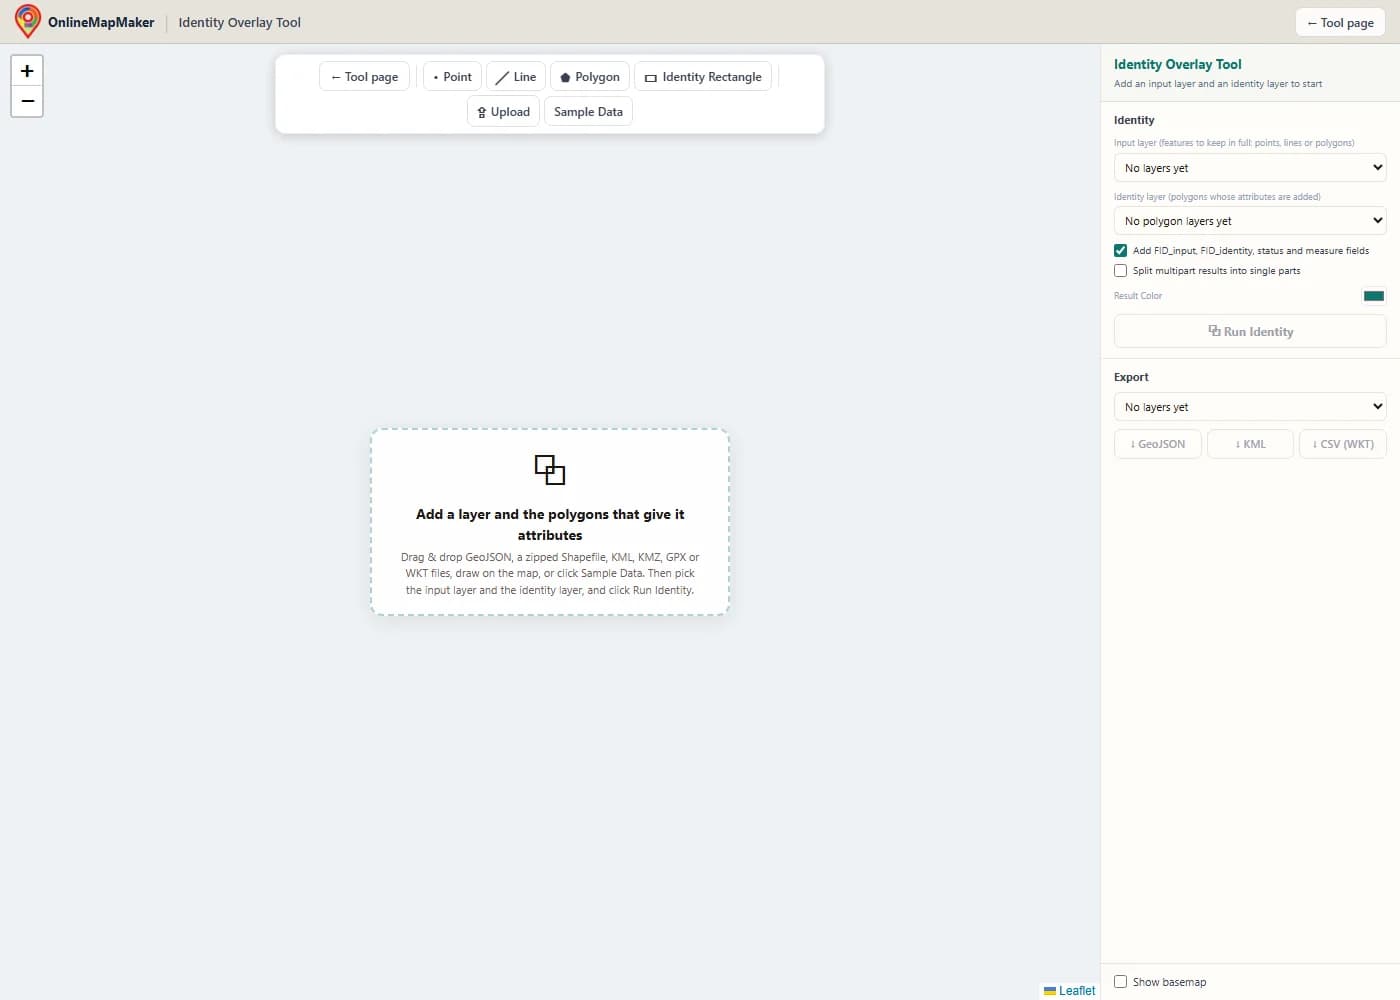
La carte s’ouvre vide et sans fond de carte, rien n’est donc chargé inutilement. La barre d’outils a les outils de dessin Point, Ligne, Polygone et Rectangle Identity, un bouton Importer et un bouton Données d’exemple.
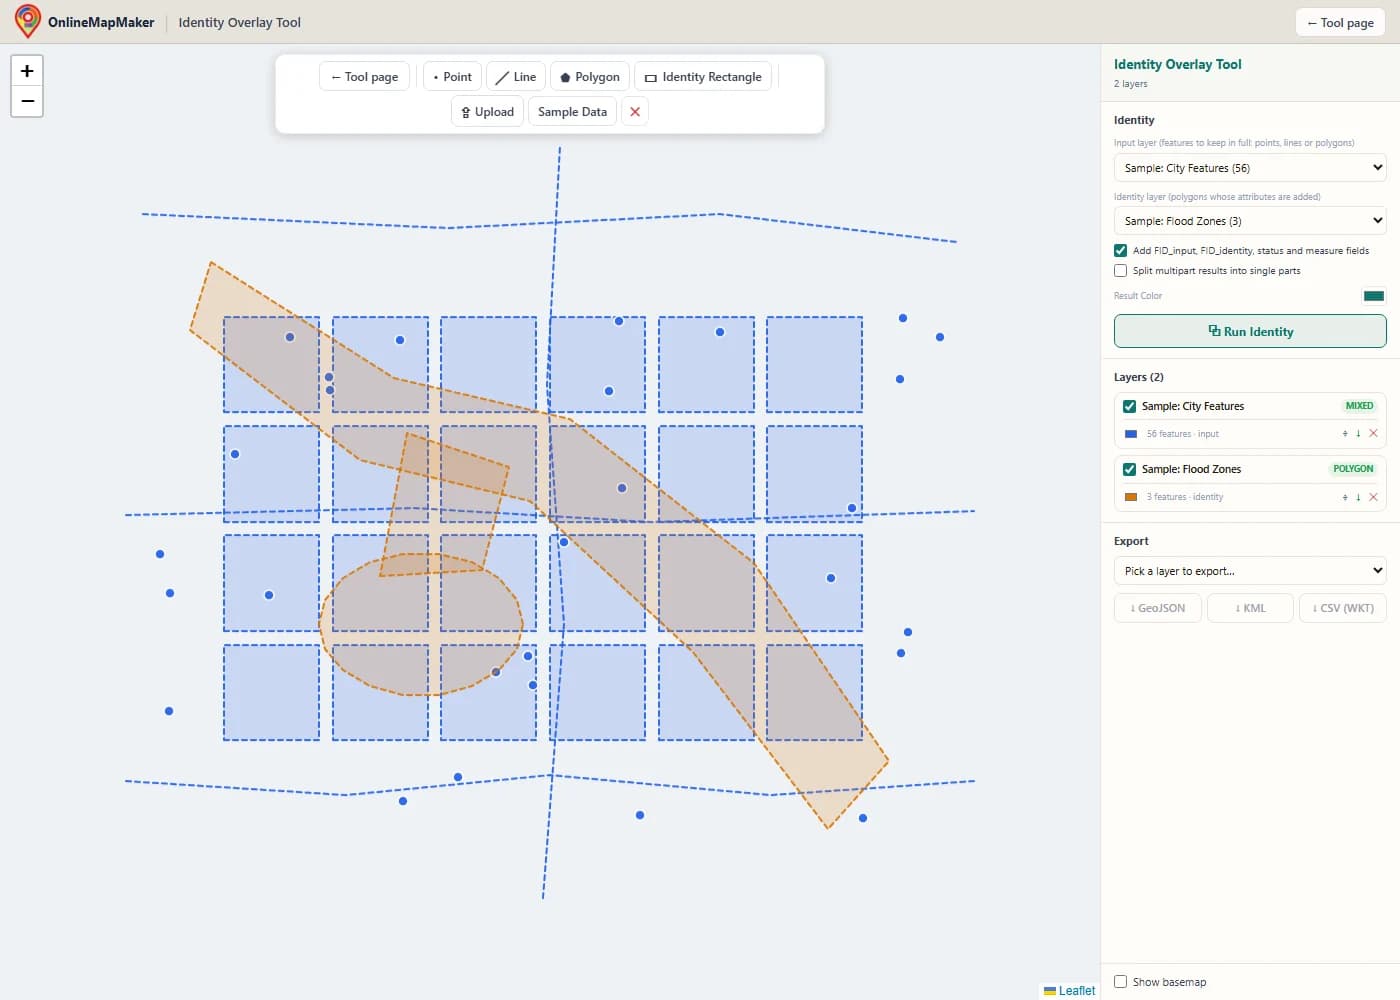
Glissez-déposez vos fichiers sur la carte, ou cliquez sur Importer. Ici, j’ai cliqué sur Données d’exemple. Cela ajoute une couche de ville avec des parcelles, des routes et des points, et une couche de zones inondables avec un lit de crue, un bassin de rétention et un déversoir qui se chevauchent.
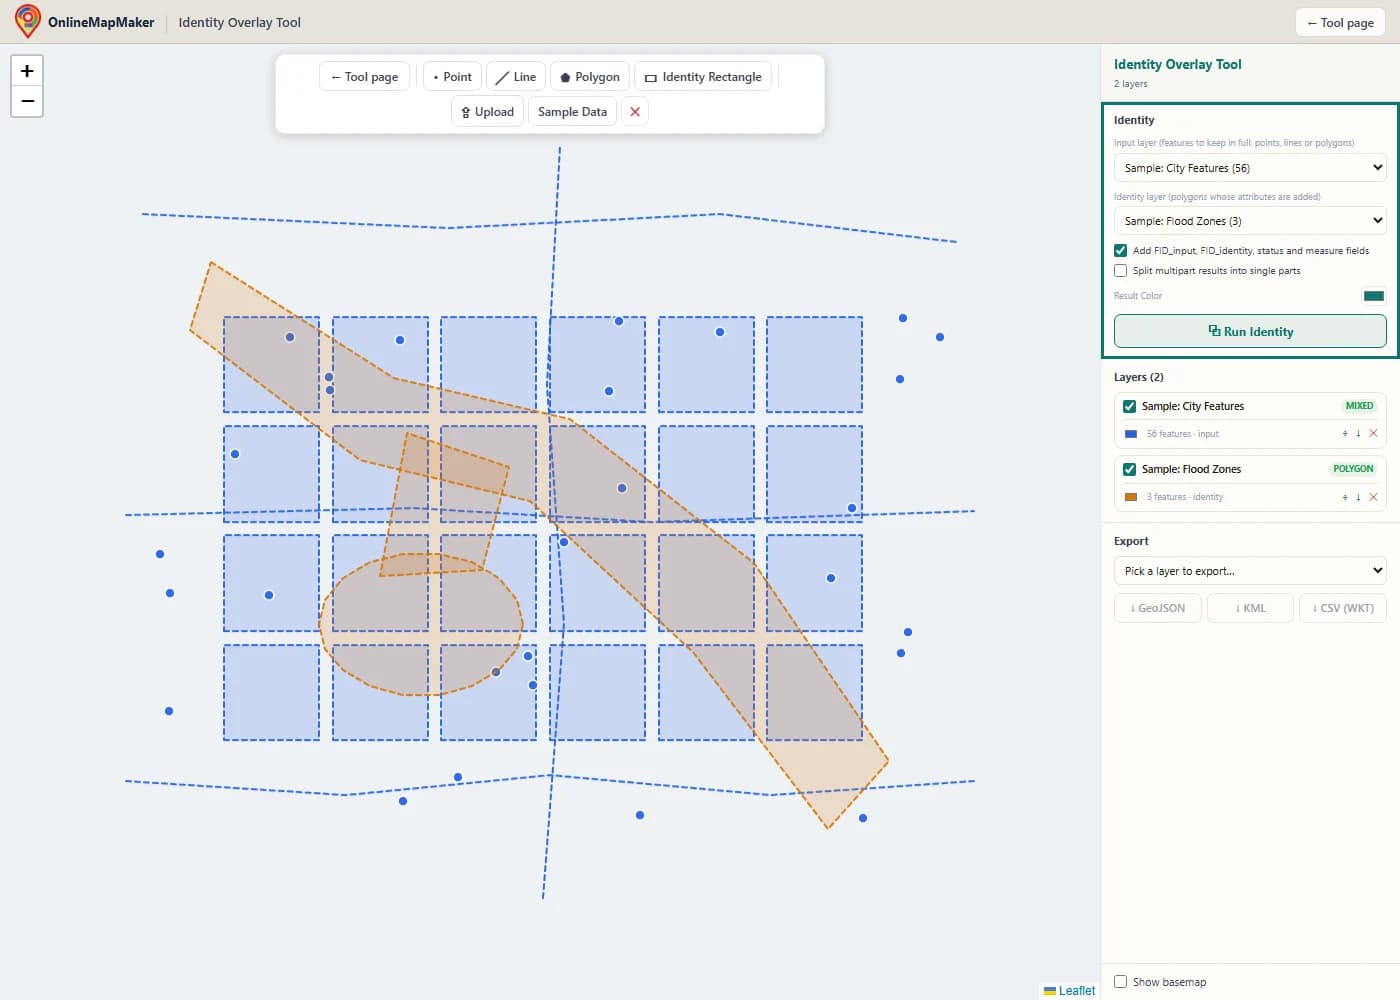
Dans le panneau Identity, choisissez la couche d’entrée (les données gardées en entier) et la couche Identity (les polygones qui donnent leurs attributs). Seules les couches avec des polygones apparaissent dans la liste Identity. Décidez si vous voulez les champs de suivi et si les résultats multiparties doivent être séparés.
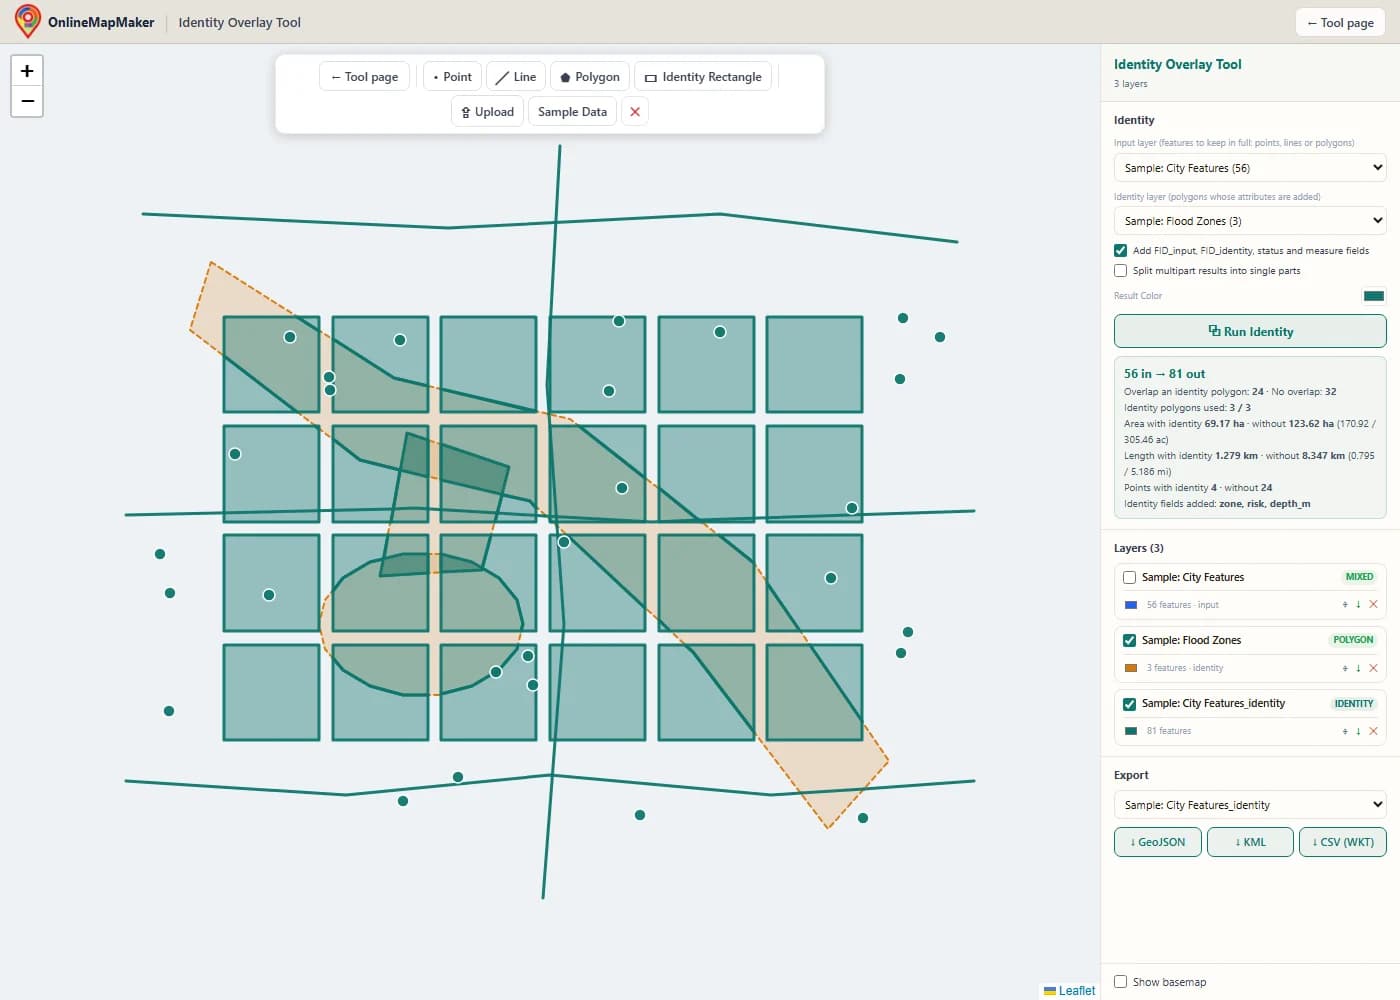
Le résultat apparaît comme une nouvelle couche, et la couche d’entrée est masquée. Chaque parcelle, route et point est toujours là, mais les parcelles et les routes sont maintenant découpées le long des limites des zones. La boîte de résultats indique combien d’entités d’entrée recoupent une zone, combien non, ainsi que la surface, la longueur et les points avec et sans attributs Identity.
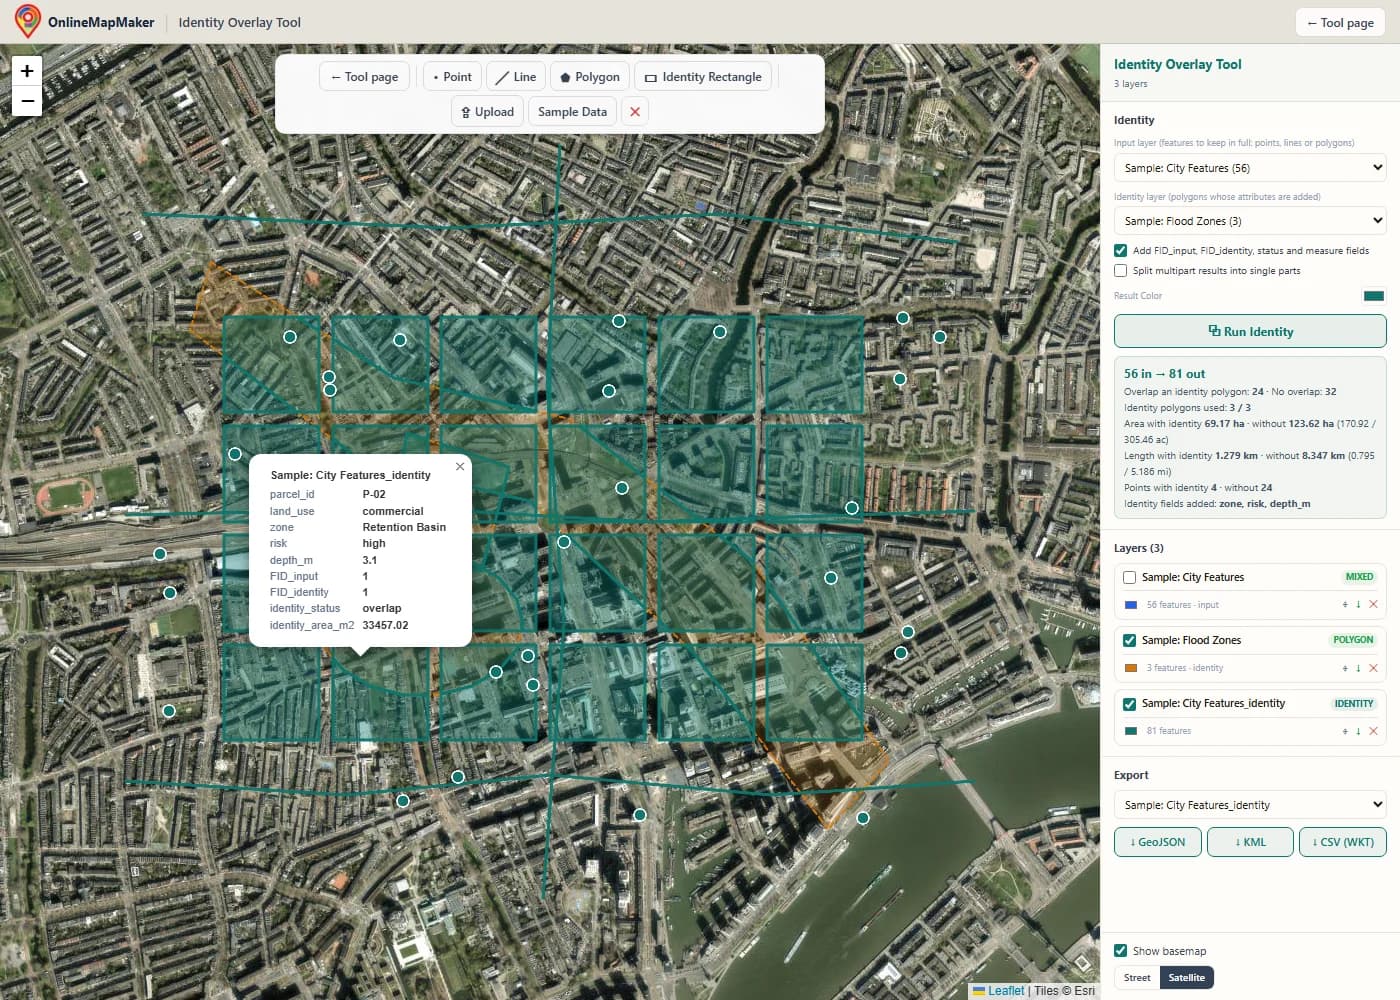
Cochez « Afficher le fond de carte » pour voir le résultat sur une carte routière ou satellite. Cliquez sur un morceau situé dans une zone pour ouvrir ses attributs. Vous voyez les champs de la parcelle et ceux de la zone dans un seul tableau. Un morceau hors de toutes les zones montre des champs de zone vides.
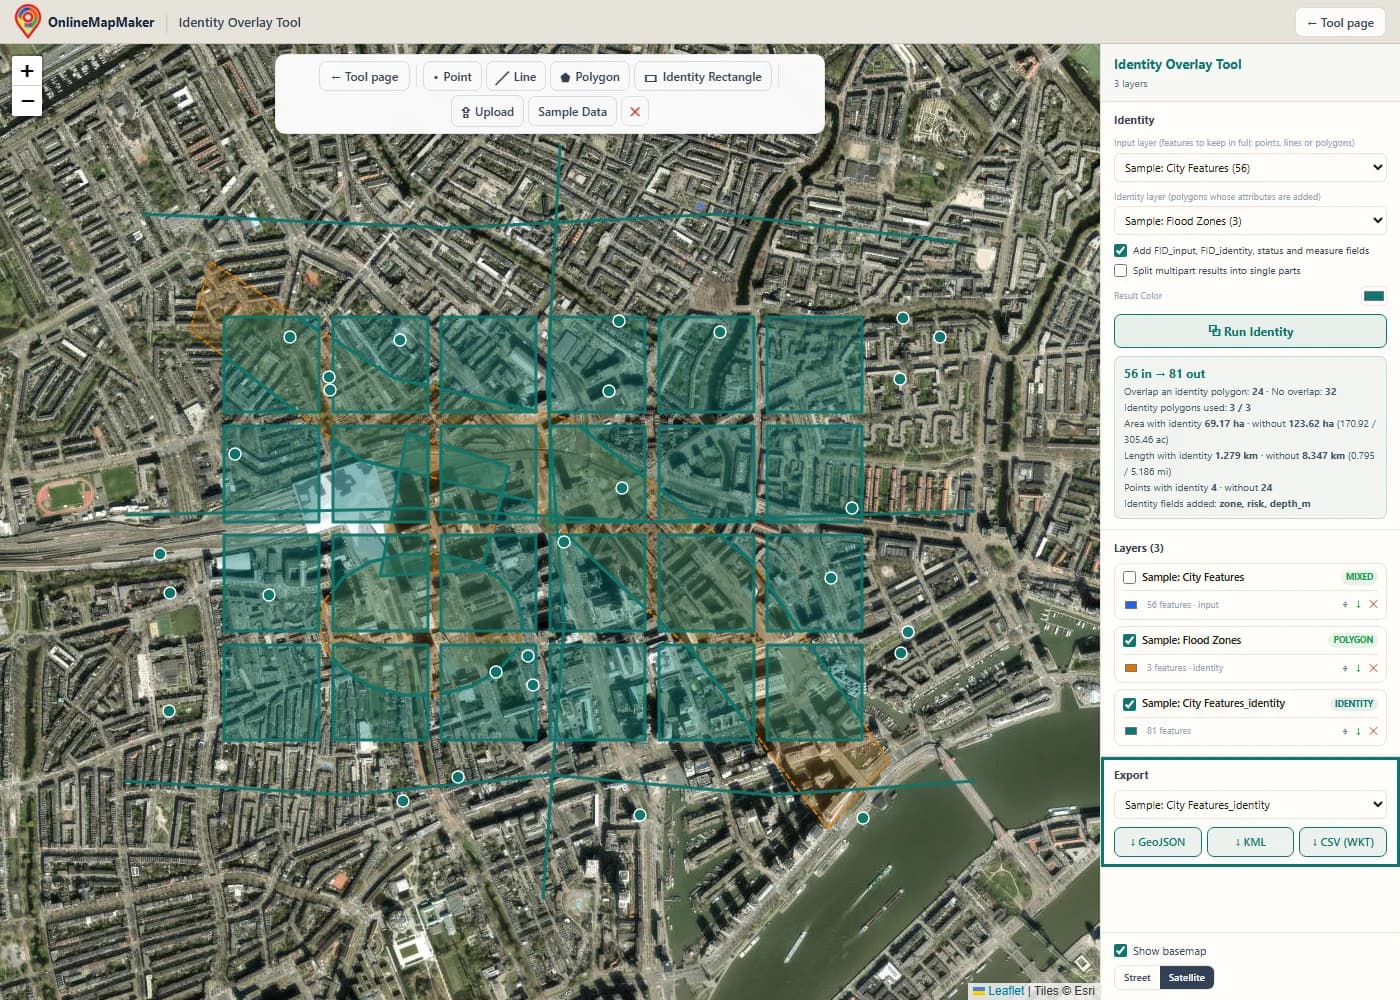
Dans le panneau Export, choisissez la couche et téléchargez-la en GeoJSON, KML ou CSV avec une colonne WKT. La petite flèche à côté de chaque couche dans le panneau Couches est un téléchargement GeoJSON rapide.
Comment faire une superposition Identity dans un SIG
Tous les SIG n’ont pas un outil de ce nom. ArcGIS l’appelle Identity, GeoPandas utilise overlay avec how="identity", et QGIS demande deux outils. Voici comment faire avec cet outil, dans ArcGIS Pro, dans ArcMap et dans QGIS, et comment l’automatiser par script.
Avec cet outil
Chargez la couche que vous voulez garder et les polygones qui apportent les attributs. Choisissez la première comme couche d’entrée et la seconde comme couche Identity, puis cliquez sur Lancer Identity. Les points, lignes et polygones d’une même couche d’entrée sont traités en un seul passage. Si vous voulez seulement étiqueter des entités avec une zone rectangulaire, cliquez sur Rectangle Identity puis sur deux coins opposés de la carte.
Dans ArcGIS Pro
Ouvrez le volet Géotraitement et cherchez Identity. Il se trouve dans la boîte Analysis, sous Overlay. Définissez Input Features et Identity Features, choisissez une sortie et l’option Join Attributes : All donne les champs FID et tous les attributs, Without FIDs omet les champs FID, et Only FIDs ne garde que les identifiants. Cliquez sur Run. Consultez la page de l’outil pour connaître le niveau de licence qu’exige votre version.
Dans ArcMap
Dans ArcMap, l’outil se trouve dans ArcToolbox > Analysis Tools > Overlay > Identity, et il exige une licence Advanced (ArcInfo). Les paramètres sont les mêmes que dans ArcGIS Pro. Esri a retiré ArcMap en mars 2026, donc pour du nouveau travail je recommande ArcGIS Pro, QGIS ou cet outil. Les anciens scripts qui appellent Identity_analysis passent à ArcGIS Pro avec de petites modifications.
Dans QGIS
QGIS n’a pas d’outil nommé Identity, mais vous pouvez le construire en trois étapes. Lancez Vecteur > Outils de géotraitement > Intersection (couche d’entrée et couche de superposition) pour obtenir les morceaux qui se chevauchent avec les deux jeux d’attributs. Lancez Vecteur > Outils de géotraitement > Différence pour obtenir les parties de l’entrée sans superposition. Puis utilisez Vecteur > Outils de gestion de données > Fusionner des couches vecteur pour réunir les deux sorties. La couche Différence n’a pas de champs de superposition, ils restent donc vides après la fusion.
Avec arcpy (Python pour ArcGIS)
Dans ArcGIS Pro, la fonction est arcpy.analysis.Identity(in_features, identity_features, out_feature_class, join_attributes, cluster_tolerance, relationship). Les anciens scripts ArcMap utilisent arcpy.Identity_analysis. Le code ci-dessous montre cette forme, ainsi que le même travail en PyQGIS, GeoPandas et PostGIS.
La même superposition Identity en code
Si vous étiquetez les mêmes couches chaque semaine, un script fait gagner du temps. Tous ces exemples découpent une couche de parcelles par zones inondables et gardent les attributs des deux.
import arcpy

arcpy.env.workspace = r"C:\data\city.gdb"

# ArcGIS Pro: Analysis toolbox > Overlay > Identity
# join_attributes: "ALL" (default), "NO_FID" or "ONLY_FID"
arcpy.analysis.Identity("parcels", "flood_zones", "parcels_zoned", "ALL")

# Older ArcMap syntax (same tool, old name)
arcpy.Identity_analysis("parcels", "flood_zones", "parcels_zoned")
# QGIS has no Identity tool: Intersection + Difference, then merge
inter = processing.run("native:intersection", {
"INPUT": "C:/data/parcels.shp",
"OVERLAY": "C:/data/flood_zones.shp",
"OUTPUT": "memory:",
})["OUTPUT"]
diff = processing.run("native:difference", {
"INPUT": "C:/data/parcels.shp",
"OVERLAY": "C:/data/flood_zones.shp",
"OUTPUT": "memory:",
})["OUTPUT"]
processing.run("native:mergevectorlayers", {
"LAYERS": [inter, diff],
"OUTPUT": "C:/data/parcels_zoned.gpkg",
})# GeoPandas
import geopandas as gpd
parcels = gpd.read_file("parcels.shp")
flood = gpd.read_file("flood_zones.shp").to_crs(parcels.crs)
parcels_zoned = gpd.overlay(parcels, flood, how="identity")
parcels_zoned.to_file("parcels_zoned.gpkg")
-- PostGIS
SELECT p.parcel_id, p.land_use, z.zone, z.risk, ST_Intersection(p.geom, z.geom) AS geom
FROM parcels p
JOIN flood_zones z ON ST_Intersects(p.geom, z.geom) AND NOT ST_Touches(p.geom, z.geom)
UNION ALL
SELECT parcel_id, land_use, NULL, NULL, geom FROM (
SELECT p.parcel_id, p.land_use,
ST_Difference(p.geom, COALESCE(
(SELECT ST_Union(z.geom) FROM flood_zones z WHERE ST_Intersects(p.geom, z.geom)),
ST_GeomFromText('POLYGON EMPTY', 4326))) AS geom
FROM parcels p
) rest
WHERE NOT ST_IsEmpty(geom);Mon avis : pour une superposition ponctuelle sur un fichier de taille normale, cet outil est le chemin le plus rapide du fichier au résultat. Dans GeoPandas, overlay(how="identity") est le script le plus court. Dans ArcGIS Pro, prenez l’outil Identity et laissez les champs FID activés, car ils permettent de retrouver facilement la source de chaque morceau.
Comment l’outil fonctionne, étape par étape
Voici le chemin de vos données à partir du clic sur Lancer Identity. Chaque étape s’exécute dans votre navigateur.
- Lire et nettoyer l’entrée. Chaque fichier est converti en entités GeoJSON en WGS84. Une GeometryCollection est découpée en entités séparées avec les mêmes attributs, de sorte que le moteur ne voit que des types de géométrie simples.
- Préparer les polygones Identity. Chaque polygone Identity reste une entité à part, avec ses attributs et sa propre boîte englobante. Rien n’est fusionné ni dissous. L’outil lit aussi les noms d’attributs des deux couches et décide des noms des champs de sortie, en renommant tout champ Identity qui entre en conflit avec un champ d’entrée.
- Trouver les polygones Identity proches. Pour chaque entité d’entrée, l’outil compare sa boîte englobante à celle de chaque polygone Identity. Seuls les polygones dont les boîtes se touchent passent au calcul détaillé. Une entité d’entrée sans aucun tel polygone est copiée tout de suite dans la sortie avec des champs Identity vides.
- Découper les points. Chaque point est testé avec un test de point dans polygone contre chaque polygone Identity proche. Un point dans un polygone (ou sur son bord) devient un point de sortie pour ce polygone, avec ses attributs. Un point dans aucun polygone est gardé avec des champs Identity vides.
- Découper les lignes. Chaque segment de ligne est testé contre les arêtes de chaque polygone proche. L’outil trouve chaque endroit où le segment croise une arête, le coupe là et teste le milieu de chaque petit morceau. Les morceaux dans un polygone vont à ce polygone. Les morceaux hors de tous les polygones proches sont rechaînés en lignes et gardés avec des champs Identity vides.
- Découper les polygones. Chaque polygone d’entrée est intersecté avec chaque polygone Identity proche par une opération booléenne à balayage (Martinez-Rueda). Chaque résultat non vide est un morceau de chevauchement avec les attributs de ce polygone. Ensuite, le polygone d’entrée moins tous les polygones Identity proches donne le morceau restant avec des champs Identity vides.
- Copier les attributs et ajouter des champs. Chaque entité de sortie reçoit une copie de tous les attributs de son entité d’entrée, puis les champs Identity (valeurs réelles ou null), puis les champs de suivi facultatifs. Si vous avez coché l’option multipartie, les résultats multiparties sont séparés ici en parties simples.
- Rapporter et dessiner. L’outil compte les entités d’entrée avec et sans correspondance, additionne la surface, la longueur et les points avec et sans attributs Identity, liste les nouveaux champs et dessine le résultat comme une nouvelle couche. La couche d’entrée est masquée pour que vous voyiez bien le résultat.
Le code des lignes est partagé avec les outils Clip et Erase de ce site. Clip garde les morceaux dont le milieu est dans le masque, Erase garde ceux dont le milieu est dehors, et Identity fait les deux, un passage par polygone Identity plus un passage pour le reste.
La théorie et les mathématiques de la superposition Identity
Identity est construit avec deux opérations ensemblistes de base sur les géométries. Voici les mathématiques, de la règle d’ensembles aux algorithmes, à l’histoire et aux mesures.
1. Identity comme intersection plus différence
Soit A la couche d’entrée et B la couche Identity, avec les polygones B1 à Bk. Chaque entité d’entrée a est remplacée par son chevauchement avec chaque Bj, plus la partie de a qui est hors de tous. Les attributs de a vont sur chaque morceau. Les attributs de Bj vont seulement sur le morceau a ∩ Bj.
Identity(A, B) = Intersect(A, B)  ∪  Erase(A, B)

pour chaque a dans A :
  morceaux de chevauchement   a ∩ Bj        (un par Bj avec a ∩ Bj ≠ ∅)   champs : a + Bj
  morceau restant             a ∖ (B1 ∪ … ∪ Bk)   (s’il n’est pas vide)   champs : a + null
L’ensemble des morceaux couvre toujours a entièrement. Si les polygones Identity ne se chevauchent pas entre eux, les morceaux ne se chevauchent pas non plus, et leur somme donne exactement a.
2. Un exemple chiffré
Prenez une parcelle P de x = 2 à 10 et y = 0 à 5 (surface 40). La zone Z1 couvre x = 0 à 6 et Z2 couvre x = 4 à 8, toutes deux de y = 0 à 10, et les deux zones se chevauchent entre x = 4 et 6. L’outil crée trois entités de sortie.
Morceau            Forme            Surface  Champs
P ∩ Z1             x 2–6, y 0–5     20       P + Z1 (zone A)
P ∩ Z2             x 4–8, y 0–5     20       P + Z2 (zone B)
P ∖ (Z1 ∪ Z2)      x 8–10, y 0–5    10       P + null

Somme des morceaux = 20 + 20 + 10 = 50
Surface de P       = 40
Écart              = 10 = surface de P ∩ Z1 ∩ Z2  (x 4–6, y 0–5, comptée deux fois)
C’est le cas à retenir. Quand des polygones Identity se chevauchent, la surface d’entrée apparaît une fois par polygone, donc les morceaux totalisent plus que l’entrée. Si vous avez besoin que les morceaux se somment exactement, dissolvez ou nettoyez d’abord la couche Identity pour que ses polygones ne se chevauchent pas.
3. La table attributaire de la sortie
Les champs de sortie sont les champs d’entrée, puis les champs Identity, puis les champs de suivi. Toutes les entités de sortie ont le même jeu de champs, ce qui permet d’ouvrir la couche sans risque dans un Shapefile ou une base de données. Un champ qui ne s’applique pas vaut null, il ne manque pas.
Champs = champs d’entrée  +  champs Identity  +  champs de suivi

Règle de conflit de noms :   name → name_1 → name_2 …  (les noms d’entrée l’emportent)

Champs de suivi (facultatifs)
  FID_input        indice de l’entité d’entrée (0, 1, 2 …)
  FID_identity     indice du polygone Identity, ou -1 pour « aucun »
  identity_status  overlap  |  input_only
La valeur -1 dans FID_identity pour « aucun polygone Identity » est la même règle qu’ArcGIS. Elle permet de filtrer les deux sortes de morceaux avec un seul test.
4. Point dans polygone : la règle du rayon
Pour décider si un point est dans un polygone Identity, tracez un rayon du point vers la droite et comptez combien de fois il croise la limite du polygone. Un nombre impair signifie dedans, un nombre pair signifie dehors. Les trous n’ont pas besoin d’un cas particulier : leurs arêtes sont comptées comme les autres, c’est pourquoi un point dans un trou ne reçoit pas les attributs de ce polygone.
Point P = (x, y). Arête de (xi, yi) à (xj, yj).

L’arête est croisée quand :
  (yi > y) ≠ (yj > y)
  et  x < xi + (y − yi) · (xj − xi) / (yj − yi)

P est dedans  ⇔  le nombre d’arêtes croisées est impair
Identity donne à P les attributs du polygone  ⇔  P est dedans ou sur une arête
5. Intersection et différence de polygones avec une ligne de balayage
Les opérations booléennes sur les polygones ont une longue histoire en infographie. Sutherland et Hodgman (1974) savaient découper contre une fenêtre convexe. Weiler et Atherton (1977) ont traité les formes concaves et les trous. Vatti (1992) puis Greiner et Hormann (1998) ont rendu le cas général praticable. Les données SIG ont besoin de ce cas général : toute forme, avec des trous, de nombreuses parties et des arêtes qui se touchent.
Cet outil utilise polyclip-ts via Turf.js. Il repose sur l’algorithme de ligne de balayage de Martínez, Rueda et Feito (2009). Une ligne verticale imaginaire se déplace de gauche à droite sur les deux polygones et ne s’arrête qu’aux sommets et aux points de croisement. À chaque arrêt, chaque arête est étiquetée comme dedans ou dehors par rapport à l’autre polygone. Pour une intersection, le résultat garde les arêtes dans l’autre polygone, et pour une différence il garde les arêtes dehors. Avec n arêtes et k croisements, le coût est d’environ O((n + k) · log n).
6. D’où vient le nom
Le nom est plus ancien que le web. ARC/INFO, le premier grand SIG vectoriel commercial, avait un ensemble de commandes de superposition : CLIP, ERASE, IDENTITY, INTERSECT, UNION et UPDATE. ArcGIS a gardé les noms. La superposition comme méthode remonte plus loin, au Canada Geographic Information System des années 1960 et aux calques de cartes dessinés à la main sur film transparent que les urbanistes utilisaient avant les ordinateurs, et qu’Ian McHarg a rendus célèbres avec « Design with Nature » (1969).
La comparaison avec le film aide encore. Identity revient à poser la carte des zones sur votre carte des parcelles, à tracer les limites des zones sur les parcelles, puis à écrire le nom de la zone sur chaque morceau.
7. Mesurer les résultats
Le panneau de résultats donne des surfaces et des longueurs sur la surface de la Terre, pas en degrés. Les surfaces utilisent la formule sphérique d’anneau de Chamberlain et Duquette (NASA JPL, 2007), que Turf.js utilise. Les longueurs utilisent la formule de haversine. Les deux utilisent le rayon moyen de la Terre R = 6 371 008,8 m.
Surface d’un anneau (λ = longitude, φ = latitude, en radians) :
A = (R² / 2) · | Σ (λ(i+1) − λ(i−1)) · sin φi |

Longueur d’un segment (haversine) :
h = sin²(Δφ / 2) + cos φ1 · cos φ2 · sin²(Δλ / 2)
d = 2R · asin(√h)

R = 6 371 008,8 m
Une sphère est un bon modèle de la Terre. Pour les surfaces et les longueurs, l’erreur est en général inférieure à 1 pour cent. C’est suffisant pour planifier et pour vérifier un résultat. Pour des valeurs légales ou de précision topographique, mesurez de nouveau dans un système de coordonnées projeté local.
Identity dans cet outil, ArcGIS Pro et QGIS comparés
Les trois donnent les mêmes morceaux pour des données normales. Ils diffèrent par le coût, l’installation et la quantité de données qu’ils gèrent. Voici une vue côte à côte.
| Caractéristique | Cet outil | ArcGIS Pro | QGIS |
|---|---|---|---|
| Nom de l’outil | Identity Overlay | Identity | Pas d’outil unique : Intersection + Différence + Fusion |
| Prix | Gratuit, sans compte | Licence ArcGIS payante | Gratuit et open source |
| Installation | Aucune, tourne dans le navigateur | Application de bureau Windows | Application de bureau pour Windows, macOS et Linux |
| Formats d’entrée | GeoJSON, Shapefile ZIP, KML, KMZ, GPX, WKT | Géodatabases, shapefiles et bien d’autres | Tout ce que GDAL/OGR sait lire |
| Gère points, lignes et polygones | Oui, même mélangés dans une couche | Oui, un type de géométrie par couche | Oui, un type de géométrie par couche |
| Attributs dans la sortie | Champs d’entrée et Identity, champs de suivi facultatifs | Champs d’entrée et Identity, champs FID en option | Champs d’entrée et de superposition via Intersection, vides via Différence |
| Automatisation | Aucune, un passage à la fois | arcpy et ModelBuilder | PyQGIS et le Modeleur graphique |
| Très gros jeux de données | Jusqu’à 50 Mo par fichier | Oui | Oui |
| Où vont vos données | Restent dans votre navigateur | Restent sur votre ordinateur | Restent sur votre ordinateur |
Ma recommandation : si vos données sont dans une géodatabase ArcGIS, utilisez l’outil Identity d’ArcGIS Pro. Il est fait pour cela, et arcpy permet de répéter le travail. Si vous voulez un SIG bureautique complet sans frais, QGIS le fait avec la recette en deux étapes ci-dessus, et GeoPandas le fait en une ligne.
Cet outil l’emporte quand il vous faut un résultat en une minute : quelqu’un vous envoie un Shapefile zippé de parcelles et un KML de zones, et il vous faut les parcelles découpées par zone avec les deux tables attributaires. Rien à installer, et rien ne quitte votre ordinateur. C’est aussi une façon claire d’apprendre comment Identity se comporte, car vous voyez chaque découpe sur la carte.
10 cas d’usage concrets
Identity répond à la question « dans quelle zone, quel secteur ou quelle classe tombe chaque partie de mon entité ? » sans rien perdre de l’entité. Voici les travaux que je vois le plus souvent.
- Parcelles découpées par zone inondable. Un urbaniste superpose des parcelles et des zones inondables. Chaque parcelle est découpée le long de la limite de zone, et chaque morceau connaît sa zone et sa profondeur d’inondation. Les parcelles hors de toutes les zones restent dans la couche avec des champs de zone vides, le nombre de parcelles ne baisse donc jamais.
- Occupation du sol et zonage. Une ville superpose ses polygones d’occupation du sol avec les zonages d’urbanisme pour trouver où l’usage réel diffère du zonage. Chaque morceau porte les deux champs, un seul filtre montre donc les écarts.
- Routes par commune. Un gestionnaire de routes découpe une couche nationale de routes selon les limites communales. Chaque tronçon reçoit le nom de la commune, et les tronçons peuvent être additionnés pour donner les kilomètres de route par commune.
- Habitat par statut de protection. Une écologue superpose une carte d’habitats avec les aires protégées. Le résultat montre, pour chaque tache d’habitat, quelle partie est protégée et sous quelle désignation, et quelle partie ne l’est pas.
- Puits et installations par bassin versant. Un hydrologue étiquette chaque point de puits avec le bassin versant où il tombe. Les points dans aucun bassin sont gardés avec des champs vides, ce qui permet aussi de repérer des points aux coordonnées erronées.
- Sols et champs agricoles. Un agronome superpose les limites de champs avec les unités de la carte des sols. Chaque champ se divise en un morceau par type de sol, et la surface par type de sol devient une colonne pour le plan de fertilisation.
- Clients par zone de service. Un distributeur superpose des points clients avec ses zones de service. Chaque client garde son enregistrement et gagne le code de zone et l’opérateur, et les clients hors de toute zone ressortent par leurs champs vides.
- Traces par région. Un randonneur ou un chercheur superpose une trace GPX avec des polygones de régions. La trace est coupée à chaque frontière, et chaque morceau porte le nom de la région, la longueur par région n’est donc qu’une somme.
- Données de recensement pour des zones sur mesure. Un analyste marketing superpose des zones de chalandise de magasins avec des secteurs de recensement. Les morceaux portent les champs des secteurs, et les parts de surface servent à pondérer les chiffres.
- Enseigner l’analyse par superposition. Les enseignants montrent Intersect, Erase et Identity côte à côte avec les mêmes données d’exemple. Les élèves voient qu’Identity est les deux premiers réunis, ce qui rend la règle d’ensembles facile à retenir.
Questions fréquentes
Des réponses directes aux questions que l’on pose sur la superposition Identity en SIG.
1. Que fait l’outil Identity en SIG ?
Identity garde chaque entité de la couche d’entrée et la découpe là où elle recoupe les polygones d’une couche Identity. Les morceaux dans un polygone reçoivent les attributs de ce polygone. Les morceaux hors de tous les polygones restent dans la sortie avec des valeurs vides dans les champs Identity. La sortie couvre toute l’entrée.
2. Quelle est la différence entre Identity et Union ?
Union garde tout des deux couches, y compris les polygones Identity qui ne touchent aucune entité d’entrée. Identity ne garde que l’étendue de la couche d’entrée. Si votre entrée est la couche qui compte et que la seconde ne fait que l’étiqueter, utilisez Identity. Si les deux couches comptent autant, utilisez Union.
3. Quelle est la différence entre Identity et Intersect ?
Intersect ne garde que la partie où les deux couches se chevauchent et écarte le reste. Identity garde aussi cette partie, et garde en plus l’entrée hors du chevauchement. Identity, c’est Intersect plus Erase.
4. Quelle est la différence entre Identity et une jointure spatiale ?
Une jointure spatiale laisse la géométrie de l’entrée inchangée et copie les attributs d’une entité correspondante. Identity découpe la géométrie le long des limites Identity, ce qui donne à chaque morceau les bons attributs. Utilisez une jointure spatiale quand les entités doivent rester entières, et Identity quand vous devez savoir quelle partie est dans quelle zone.
5. QGIS a-t-il un outil Identity ?
Pas sous ce nom. Dans QGIS, vous lancez Intersection et Différence avec les deux mêmes couches et vous fusionnez les sorties avec Fusionner des couches vecteur. Le résultat correspond à Identity. Dans GeoPandas, le même travail est overlay(df1, df2, how="identity").
6. Quels attributs la sortie garde-t-elle ?
Chaque attribut de l’entité d’entrée est copié sur chaque morceau. Les attributs du polygone Identity sont ajoutés comme nouveaux champs. Les morceaux hors de tous les polygones Identity ont des valeurs null dans ces champs. En option, l’outil ajoute FID_input, FID_identity, identity_status et la surface, la longueur ou le nombre de points de chaque morceau.
7. Que se passe-t-il quand un champ Identity porte le même nom qu’un champ d’entrée ?
Le champ d’entrée garde son nom et le champ Identity reçoit un suffixe, par exemple name et name_1. C’est la même règle qu’ArcGIS. La boîte de résultats liste chaque champ renommé, vous voyez donc ce qui a changé.
8. Pourquoi ma sortie a-t-elle plus d’entités que mon entrée ?
Les entités sont découpées là où elles croisent une limite Identity, une entité d’entrée peut donc donner plusieurs morceaux de sortie. Si vos polygones Identity se chevauchent entre eux, le chevauchement apparaît aussi une fois par polygone. Activez les champs FID et regroupez par FID_input pour voir quels morceaux viennent de la même entité.
9. Puis-je utiliser des lignes et des points, ou seulement des polygones ?
En entrée, vous pouvez utiliser les trois. Les lignes sont découpées aux limites Identity, et les points reçoivent les attributs du polygone qui les contient. La couche Identity doit avoir des polygones, car seul un polygone apporte une surface à superposer.
10. Que deviennent les entités exactement sur une limite Identity ?
Le bord compte comme à l’intérieur. Un point exactement sur le bord reçoit les attributs de ce polygone, de même qu’un tronçon de ligne qui longe le bord. Un polygone qui ne touche la limite que de l’extérieur n’est pas découpé. Un point sur une limite partagée par deux polygones Identity donne deux points de sortie, un pour chaque polygone.
11. Pourquoi les surfaces de mes morceaux totalisent-elles plus que l’entrée ?
Cela arrive quand des polygones Identity se chevauchent entre eux. La surface d’entrée dans le chevauchement est comptée une fois par polygone. Nettoyez ou dissolvez d’abord la couche Identity si vous avez besoin que les morceaux se somment exactement. L’exemple chiffré de cette page montre les nombres.
12. Quels formats de fichier puis-je envoyer et télécharger ?
Vous pouvez envoyer du GeoJSON, un Shapefile Esri zippé (avec .shp, .shx et .dbf, plus .prj pour des données projetées), du KML, du KMZ, du GPX et du WKT. Vous pouvez télécharger du GeoJSON, du KML et du CSV avec une colonne de géométrie WKT. GeoJSON est le meilleur choix pour ArcGIS Pro ou QGIS, car il garde les types d’attributs.
13. Mes données sont-elles envoyées à un serveur ?
Non. La lecture des fichiers, la superposition et l’écriture de la sortie s’exécutent dans votre navigateur. Vos fichiers ne quittent jamais votre ordinateur. Seules les tuiles facultatives du fond de carte viennent d’internet, et seulement après que vous avez activé le fond de carte.
14. Puis-je utiliser des données projetées, comme l’UTM ?
L’outil travaille en longitude et latitude WGS84 (EPSG:4326). Un Shapefile zippé en UTM ou en grille nationale est converti en WGS84 au chargement, tant que son fichier .prj est dans le ZIP. Le GeoJSON doit déjà être en WGS84, comme l’exige le standard GeoJSON.
15. Aucune entité n’a reçu d’attributs Identity. Qu’est-ce qui n’a pas marché ?
La cause la plus courante est que les deux couches ne se chevauchent pas. Activez le fond de carte et zoomez sur chaque couche pour vérifier où elles se trouvent. Un Shapefile sans son fichier .prj atterrit souvent au mauvais endroit. Vérifiez aussi que vous avez choisi la couche de polygones comme couche Identity, et non comme entrée.
16. Comment lancer Identity avec arcpy ou GeoPandas ?
Dans ArcGIS Pro, appelez arcpy.analysis.Identity("parcels", "flood_zones", "parcels_zoned"). Dans GeoPandas, appelez geopandas.overlay(parcels, flood, how="identity"). Les deux sont présentés avec le code complet sur cette page. Une boucle for sur plusieurs couches est l’endroit où les scripts font gagner le plus de temps.
17. Les chiffres de surface et de longueur sont-ils exacts ?
Ils sont mesurés sur une sphère de rayon 6 371 008,8 m, ce sont donc de vrais mètres carrés et mètres, pas des degrés. L’erreur par rapport au vrai ellipsoïde est en général inférieure à 1 pour cent. Pour des valeurs légales ou de précision topographique, mesurez de nouveau dans un système de coordonnées projeté local.
Bibliothèques utilisées et crédits
Cet outil repose sur des logiciels libres. Un grand merci aux personnes qui écrivent et maintiennent ces projets.
- Leaflet 1.9 · BSD-2-Clause · Volodymyr Agafonkin and contributorsDessine la carte interactive, les couches, les outils de dessin et les fenêtres d’information.
- Turf.js 7 (@turf/intersect, @turf/difference, @turf/area, @turf/boolean-point-in-polygon) · MIT · Turf authorsIntersection et différence de polygones pour la superposition, surface géodésique et test de point dans polygone.
- polyclip-ts · MIT · Luiz Felipe Machado Barboza, based on polygon-clipping by Mike FogelLe moteur booléen de polygones derrière intersect et difference de Turf. Il utilise l’algorithme de balayage de Martinez-Rueda avec une arithmétique de précision arbitraire.
- point-in-polygon-hao · MIT · Rowan WinsemiusLe test rapide de point dans polygone qui décide quels points et morceaux de ligne tombent dans chaque polygone Identity.
- shpjs · MIT · Calvin MetcalfLit les Shapefiles Esri zippés (.shp, .shx, .dbf, .prj, .cpg) dans le navigateur.
- proj4js · MIT · proj4js contributorsConvertit les Shapefiles projetés en WGS84 grâce à leur fichier .prj (utilisé par shpjs).
- @tmcw/togeojson · BSD-2-Clause · Tom MacWrightConvertit les fichiers KML et GPX en GeoJSON.
- JSZip · MIT ou GPL-3.0 · Stuart KnightleyOuvre les archives KMZ pour lire le fichier KML qu’elles contiennent.
- @terraformer/wkt · MIT · Terraformer contributorsLit l’entrée WKT et écrit la colonne de géométrie WKT dans l’export CSV.
- OpenStreetMap, Protomaps (hosted by KONAKTIVE), CARTO, Esri World Imagery · ODbL et conditions du fournisseur · OpenStreetMap contributors, Protomaps, KONAKTIVE, CARTO, EsriTuiles et imagerie du fond de carte, affichées seulement quand vous activez le fond de carte.
L’étape de découpe des lignes (couper les segments aux croisements de limites et tester chaque morceau) a été écrite pour ce site et est partagée avec les outils Clip et Erase. Le moteur Identity est vérifié par des tests automatiques : polygones qui traversent une ou deux zones, lignes à travers des trous, points dans deux zones qui se chevauchent et sur des limites, noms de champs en conflit, et la règle selon laquelle les morceaux de chevauchement plus les morceaux restants couvrent toute l’entrée.
Outils de géotraitement associés
Tout le travail de superposition s’exécute dans votre navigateur. Aucun fichier n’est jamais envoyé à un serveur. Tuiles de carte © contributeurs d'OpenStreetMap, dessinées avec Protomaps (hébergé par KONAKTIVE), avec CARTO en secours. Images satellite : Esri.
